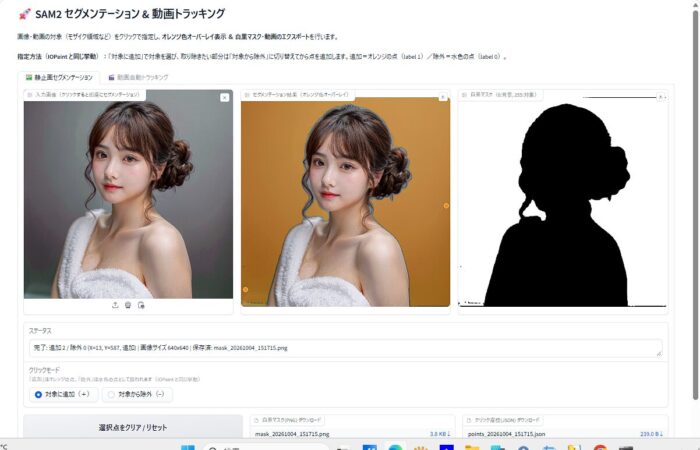
import os
import json
import time
import shutil
import hashlib
import tempfile
import traceback
import zipfile
import subprocess
from concurrent.futures import ThreadPoolExecutor
import cv2
import gradio as gr
import numpy as np
from PIL import Image, ImageDraw
import torch
from omegaconf import OmegaConf
from hydra.utils import instantiate
from sam2.sam2_image_predictor import SAM2ImagePredictor
# パス設定
_SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
MODEL_CFG = os.path.join(_SCRIPT_DIR, "sam2.1_hiera_l.yaml")
CHECKPOINT = os.path.join(_SCRIPT_DIR, "checkpoints", "sam2.1_hiera_large.pt")
OUTPUTS_DIR = os.path.join(_SCRIPT_DIR, "outputs")
os.makedirs(OUTPUTS_DIR, exist_ok=True)
device = "cuda" if torch.cuda.is_available() else "cpu"
# ----------------------------------------------------
# モデル構築(静止画用 & 動画用 Lazy Load)
# ----------------------------------------------------
def build_image_model(cfg_path: str, ckpt_path: str):
cfg = OmegaConf.load(cfg_path)
model = instantiate(cfg.model)
state = torch.load(ckpt_path, map_location="cpu")
sd = state.get("model", state)
model.load_state_dict(sd, strict=False)
model.to(device)
model.eval()
return model
image_model = build_image_model(MODEL_CFG, CHECKPOINT)
image_predictor = SAM2ImagePredictor(image_model)
_video_predictor = None
def get_video_predictor():
global _video_predictor
if _video_predictor is None:
cfg = OmegaConf.load(MODEL_CFG)
cfg.model._target_ = "sam2.sam2_video_predictor.SAM2VideoPredictor"
cfg.model.fill_hole_area = 8
model = instantiate(cfg.model, _recursive_=True)
state = torch.load(CHECKPOINT, map_location="cpu")
sd = state.get("model", state)
model.load_state_dict(sd, strict=False)
model.to(device)
model.eval()
_video_predictor = model
return _video_predictor
# ----------------------------------------------------
# 共通ヘルパー関数
# ----------------------------------------------------
_cached_image = {"md5": None, "np": None}
def ensure_image_set(pil_img):
"""IOPaint と同じく画像の md5 でキャッシュし、同じ画像は set_image しない"""
img_np = np.array(pil_img.convert("RGB"))
img_md5 = hashlib.md5(img_np.tobytes()).hexdigest()
if _cached_image["md5"] != img_md5:
image_predictor.set_image(img_np)
_cached_image["md5"] = img_md5
_cached_image["np"] = img_np
return _cached_image["np"]
# 点の色(Positive = 対象に追加 / Orange, Negative = 対象から除外 / 水色)
POINT_COLORS = {1: (255, 140, 0), 0: (0, 170, 255)}
def _point_label(pt):
"""[x, y] または [x, y, label] から label(1=追加 / 0=除外) を取り出す"""
try:
return 1 if int(pt[2]) else 0
except (IndexError, TypeError, ValueError):
return 1
def draw_points(image, points, radius=6):
if image is None or not points:
return image
img_draw = image.copy().convert("RGB")
draw = ImageDraw.Draw(img_draw)
for pt in points:
if not pt or len(pt) < 2 or pt[0] is None or pt[1] is None:
continue
try:
x, y = int(pt[0]), int(pt[1])
except (ValueError, TypeError):
continue
color = POINT_COLORS[_point_label(pt)]
draw.ellipse([x - radius - 1, y - radius - 1, x + radius + 1, y + radius + 1], fill=(255, 255, 255))
draw.ellipse([x - radius, y - radius, x + radius, y + radius], fill=color)
return img_draw
def _to_coord(x, y, image=None):
"""(x, y) を整数画像座標へ変換する。null / NaN / 変換不能なら None を返す。
image が渡された場合は画像サイズ内にクランプする。"""
if x is None or y is None:
return None
try:
# float('nan') / 'inf' は int() で ValueError / OverflowError になるので弾かれる
ix, iy = int(round(float(x))), int(round(float(y)))
except (TypeError, ValueError, OverflowError):
return None
if image is not None:
try:
w, h = image.size
except (AttributeError, TypeError, ValueError):
return None
ix = max(0, min(w - 1, ix))
iy = max(0, min(h - 1, iy))
return (ix, iy)
def extract_coords(evt: gr.SelectData, image=None):
"""Gradio の SelectData から (x, y) 座標を抽出する
gradio 4.10.0 の標準形式は index=[x, y](リスト)。
フロントエンドの不具合で index=[null, null] が届くケースがあるため、
null / NaN は「座標なし」として扱う。
"""
if evt is None:
return None, "イベントデータが取得できませんでした。画像をもう一度クリックしてください。"
idx = getattr(evt, "index", None)
val = getattr(evt, "value", None)
# 1. 2要素のリスト/タプル(gradio の標準形式)
if isinstance(idx, (list, tuple)) and len(idx) >= 2:
coord = _to_coord(idx[0], idx[1], image)
if coord is not None:
return coord, None
# 2. 辞書型
elif isinstance(idx, dict):
inner = idx.get("index")
x = idx.get("x", idx.get("col"))
y = idx.get("y", idx.get("row"))
if x is None and y is None and isinstance(inner, (list, tuple)) and len(inner) >= 2:
x, y = inner[0], inner[1]
coord = _to_coord(x, y, image)
if coord is not None:
return coord, None
# 3. 単一数値(フラット化インデックス: idx = y * width + x)
elif isinstance(idx, (int, float)) and not isinstance(idx, bool) and image is not None:
try:
w, h = image.size
raw_idx = int(idx)
coord = _to_coord(raw_idx % w, raw_idx // w, image)
if coord is not None:
return coord, None
except (TypeError, ValueError, OverflowError, ZeroDivisionError):
pass
# 4. evt.value からのフォールバック
if isinstance(val, (list, tuple)) and len(val) >= 2:
coord = _to_coord(val[0], val[1], image)
if coord is not None:
return coord, None
return None, (
f"クリック位置の座標を取得できませんでした(受信: index={idx}, value={val})。"
"ブラウザが古い JavaScript をキャッシュしている可能性があります。"
"ページを再読み込み(Ctrl+F5)してから画像の中央付近をクリックするか、"
"『手動座標で指定』から座標を直接入力してください。"
)
# ----------------------------------------------------
# 1. 静止画セグメンテーション & マスク・座標エクスポート
# ----------------------------------------------------
@torch.inference_mode()
def process_segmentation_with_point(image, points, cur_x, cur_y, cur_label=1):
"""(cur_x, cur_y, cur_label) を points に追加してセグメンテーションを実行
IOPaint の InteractiveSeg.forward() と同じ呼び出し方にする:
- multimask_output=False(1 枚だけ採用。_scores の argmax は使わない)
- label=1 で対象に追加 / label=0 で対象から除外
- torch.inference_mode() で実行
"""
valid_points = []
for pt in (points or []):
if isinstance(pt, (list, tuple)) and len(pt) >= 2:
if pt[0] is not None and pt[1] is not None:
try:
valid_points.append([int(pt[0]), int(pt[1]), _point_label(pt)])
except (ValueError, TypeError):
continue
valid_points.append([int(cur_x), int(cur_y), 1 if int(cur_label) else 0])
image_np = ensure_image_set(image)
point_coords = np.array([p[:2] for p in valid_points], dtype=np.float32)
point_labels = np.array([p[2] for p in valid_points], dtype=np.int32)
masks, scores, _ = image_predictor.predict(
point_coords=point_coords,
point_labels=point_labels,
multimask_output=False
)
if isinstance(masks, torch.Tensor):
masks = masks.detach().cpu().numpy()
if isinstance(scores, torch.Tensor):
scores = scores.detach().cpu().numpy()
best_mask = masks[0]
if best_mask.ndim == 3 and best_mask.shape[0] == 1:
best_mask = best_mask.squeeze(0)
bool_mask = (best_mask > 0.0)
# 1. オレンジ色オーバーレイ画像
overlay = image_np.copy()
orange_color = np.array([255, 140, 0], dtype=np.float32)
alpha = 0.5
if bool_mask.any():
target_pixels = overlay[bool_mask].astype(np.float32)
blended = target_pixels * (1.0 - alpha) + orange_color * alpha
overlay[bool_mask] = np.clip(blended, 0, 255).astype(np.uint8)
result_img = Image.fromarray(overlay)
result_img = draw_points(result_img, valid_points)
# 2. 白黒マスク画像 (0 or 255)
bw_mask_np = (bool_mask.astype(np.uint8) * 255)
bw_mask_img = Image.fromarray(bw_mask_np)
# 3. エクスポート用ファイル自動生成
timestamp = time.strftime("%Y%m%d_%H%M%S")
mask_path = os.path.join(OUTPUTS_DIR, f"mask_{timestamp}.png")
bw_mask_img.save(mask_path)
json_path = os.path.join(OUTPUTS_DIR, f"points_{timestamp}.json")
with open(json_path, "w", encoding="utf-8") as f:
json.dump({
"timestamp": timestamp,
"points": valid_points,
"point_labels": point_labels.tolist(),
"image_size": [image_np.shape[1], image_np.shape[0]]
}, f, indent=2)
n_pos = int(sum(p[2] for p in valid_points))
n_neg = len(valid_points) - n_pos
status_text = (
f"完了: 追加 {n_pos} / 除外 {n_neg} "
f"(X={cur_x}, Y={cur_y}, {'追加' if int(cur_label) else '除外'}) | "
f"画像サイズ {image_np.shape[1]}x{image_np.shape[0]} | "
f"保存済: {os.path.basename(mask_path)}"
)
return valid_points, result_img, bw_mask_img, mask_path, json_path, status_text
def on_image_select(image, points, evt: gr.SelectData, cur_label=1):
try:
if image is None:
return points or [], None, None, None, None, "画像をアップロードしてください"
coord, err_msg = extract_coords(evt, image)
if coord is None:
return points or [], None, None, None, None, err_msg
return process_segmentation_with_point(image, points, coord[0], coord[1], cur_label)
except Exception as e:
traceback.print_exc()
return points or [], None, None, None, None, f"エラー: {e}"
def on_image_manual_point(image, points, cur_x, cur_y, cur_label=1):
"""クリックを使わず、手動で入力した座標でセグメンテーションを実行する"""
try:
if image is None:
return points or [], None, None, None, None, "画像をアップロードしてください"
coord = _to_coord(cur_x, cur_y, image)
if coord is None:
return points or [], None, None, None, None, "X と Y に数値を入力してください"
return process_segmentation_with_point(image, points, coord[0], coord[1], cur_label)
except Exception as e:
traceback.print_exc()
return points or [], None, None, None, None, f"エラー: {e}"
def on_image_reset(image=None):
if image is None:
return [], None, None, None, None, "画像をアップロードしてください"
w, h = image.size
return [], None, None, None, None, (
f"画像サイズ: {w} x {h} px。対象をクリックしてください"
"(クリックが反応しない場合は『手動座標で指定』から X / Y を入力)"
)
# ----------------------------------------------------
# 2. 動画トラッキング処理
# ----------------------------------------------------
_video_state = {
"temp_dir": None,
"fps": 30,
"width": 0,
"height": 0,
"total_frames": 0,
"first_frame_pil": None,
}
def on_video_upload(video_path, max_frames):
"""動画がアップロードされたら、フレームを一時展開して第1フレームを表示
※ 戻り値は 7 個(image / state / video / video / file(mask mp4) / file(zip) / textbox)
"""
if video_path is None:
return None, [], None, None, None, None, "動画ファイルをアップロードしてください"
try:
# 既存の一時フォルダがあればクリーンアップ
if _video_state["temp_dir"] and os.path.exists(_video_state["temp_dir"]):
shutil.rmtree(_video_state["temp_dir"], ignore_errors=True)
temp_dir = tempfile.mkdtemp(prefix="sam2_video_")
_video_state["temp_dir"] = temp_dir
cap = cv2.VideoCapture(video_path)
if not cap.isOpened():
return None, [], None, None, None, None, "動画ファイルを開けませんでした"
fps = cap.get(cv2.CAP_PROP_FPS) or 30.0
width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
total = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
_video_state["fps"] = fps
_video_state["width"] = width
_video_state["height"] = height
frame_idx = 0
first_frame = None
limit = min(int(max_frames), total) if max_frames else total
# 読み込みは.VideoCapture をスレッド跨ぎできないので順次、
# JPEG エンコード(cv2.imwrite は GIL を解放する)だけ並列化する
jpg_pool = ThreadPoolExecutor(max_workers=8)
try:
while True:
ret, frame = cap.read()
if not ret or frame_idx >= limit:
break
frame_filename = os.path.join(temp_dir, f"{frame_idx:05d}.jpg")
jpg_pool.submit(cv2.imwrite, frame_filename, frame)
if frame_idx == 0:
first_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
frame_idx += 1
finally:
cap.release()
jpg_pool.shutdown(wait=True)
_video_state["total_frames"] = frame_idx
if first_frame is None:
return None, [], None, None, None, None, "フレームの読み込みに失敗しました"
first_pil = Image.fromarray(first_frame)
_video_state["first_frame_pil"] = first_pil
msg = f"動画展開完了: {frame_idx} フレーム ({width}x{height}, {fps:.1f} fps) | 第1フレームの対象をクリックしてください"
return first_pil, [], None, None, None, None, msg
except Exception as e:
traceback.print_exc()
return None, [], None, None, None, None, f"動画展開エラー: {e}"
# -------------------------------------------------
# 動画書き出し(Gradio のプレビューで再生できる mp4 にする)
# mp4v(MPEG-4 Part 2)は Chrome/Edge/Firefox で再生できないため
# avc1(H.264 / Baseline / yuv420p)を優先し、書けなければ mp4v にフォールバックする。
# -------------------------------------------------
_BROWSER_CODECS = ["avc1", "mp4v"]
_WORKING_FOURCC = None # 一度成功した FourCC を覚える(2 本目以降の codec 探索 ~1.7 秒を省く)
_USE_GPU = bool(torch.cuda.is_available())
_OVERLAY_ALPHA = 0.5
_VIDEO_BACKEND = None # "ffmpeg" か "opencv" か(起動後 1 回だけ判定)
_SILENCED_STDERR = None
_GPU_BLEND_ENABLED = None # GPU 合成が使えるか(CUDA メモリ不足で False に落とす)
ERROR_LOG_PATH = os.path.join(_SCRIPT_DIR, "error_log.txt")
def _log_exception(stage, exc):
"""エラー内容をコンソールと error_log.txt に残す(Starlette に潰される前に)"""
try:
detail = "".join(traceback.format_exception(type(exc), exc, exc.__traceback__))
except Exception:
detail = f"{type(exc).__name__}: {exc}"
print(f" {stage} でエラー: {type(exc).__name__}: {exc}")
try:
with open(ERROR_LOG_PATH, "a", encoding="utf-8") as f:
f.write(f"\n===== {time.strftime('%Y-%m-%d %H:%M:%S')} / {stage} =====\n")
f.write(detail)
except OSError:
pass
def _blend_overlay_gpu(frame_bgr, mask_bool_gpu):
"""オレンジ合成を GPU で行う(mask は SAM2 から GPU 上のまま受け取るので CPU 往復を 1 回減らせる)
frame_bgr : (H, W, 3) uint8 の BGR フレーム(CPU)
mask_bool_gpu : (H, W) bool の torch.Tensor(GPU)
戻り値 : 合成後の (H, W, 3) uint8 ndarray(CPU。H.264 エンコード用)
"""
global _GPU_BLEND_ENABLED
device = mask_bool_gpu.device
frame = torch.from_numpy(np.ascontiguousarray(frame_bgr)).to(device, non_blocking=True)
m = mask_bool_gpu.reshape(*mask_bool_gpu.shape[-2:], 1)
orange = torch.tensor([0.0, 140.0, 255.0], device=device).view(1, 1, 3) # BGR
f = frame.to(torch.float32)
blended = f * (1.0 - _OVERLAY_ALPHA) + orange * _OVERLAY_ALPHA
out = torch.where(m, blended, f)
return out.clamp_(0, 255).to(torch.uint8).cpu().numpy()
def _blend_overlay_cpu(frame_bgr, mask_bool):
"""GPU が使えないときの CPU 合成(numpy)"""
overlay_bgr = frame_bgr.copy()
if mask_bool.any():
orange_bgr = np.array([0, 140, 255], dtype=np.float32) # BGR
target_pixels = overlay_bgr[mask_bool].astype(np.float32)
blended = target_pixels * (1.0 - _OVERLAY_ALPHA) + orange_bgr * _OVERLAY_ALPHA
overlay_bgr[mask_bool] = np.clip(blended, 0, 255).astype(np.uint8)
return overlay_bgr
def _disable_gpu_blend(reason_exc):
"""GPU 合成を無効化して CPU に落とす(VRAM 6GB では大容量動画だと OOM しうるため)"""
global _GPU_BLEND_ENABLED
_GPU_BLEND_ENABLED = False
print(" GPU メモリ不足のため、以降の合成は CPU で行います")
print(" (「処理する最大フレーム数」を小さくすると解消します)")
_log_exception("オーバーレイ合成(GPU → CPU に切替)", reason_exc)
try:
torch.cuda.empty_cache()
except Exception:
pass
def _blend_overlay(frame_bgr, mask_bool_gpu, bw_mask):
"""サイズも CUDA も問題ないように GPU / CPU を使い分ける合成
CUDA メモリ不足(OOM)が起きた場合は GPU 合成を無効化して CPU に恒久フォールバックする。
"""
global _GPU_BLEND_ENABLED
if _GPU_BLEND_ENABLED is None:
_GPU_BLEND_ENABLED = _USE_GPU
same_size = tuple(bw_mask.shape) == tuple(mask_bool_gpu.shape[-2:])
if _GPU_BLEND_ENABLED and _USE_GPU and same_size:
try:
return _blend_overlay_gpu(frame_bgr, mask_bool_gpu)
except Exception as e:
oom = isinstance(e, getattr(torch.cuda, "OutOfMemoryError", ())) \
or "out of memory" in str(e).lower()
if not oom:
raise
_disable_gpu_blend(e)
return _blend_overlay_cpu(frame_bgr, bw_mask > 0)
def _even_dim(n):
"""H.264 は縦横が偶数でないと書けないので偶数に合わせる"""
n = int(n)
n -= (n % 2)
return max(2, n)
def _silence_stderr():
"""OpenCV の codec 探知ログ(libopenh264 -load 失敗など)を一時的に標準エラー出力から外す"""
global _SILENCED_STDERR
return _StdErrSilencer()
class _StdErrSilencer:
"""fd 2 を一時的に devnull に向ける(cv2 の C レベル出力は sys.stderr じゃ消せないため)"""
def __enter__(self):
global _SILENCED_STDERR
self._saved = None
if _SILENCED_STDERR is None: # 入れ子の同時実行を避ける
try:
import os as _os
self._saved = _os.dup(2)
devnull = _os.open(_os.devnull, _os.O_WRONLY)
_os.dup2(devnull, 2)
_os.close(devnull)
_SILENCED_STDERR = self
except Exception:
self._saved = None
return self
def __exit__(self, *exc):
global _SILENCED_STDERR
if self._saved is not None:
try:
import os as _os
_os.dup2(self._saved, 2)
_os.close(self._saved)
except Exception:
pass
_SILENCED_STDERR = None
return False
class _FfmpegVideoWriter:
"""ffmpeg プロセスへ BGR24 の raw frame を流し込む(cv2.VideoWriter 互換の最小インターフェース)"""
def __init__(self, proc, log_path):
self._proc = proc
self._log_path = log_path
self._closed = False
self._failed = False
self._broken = False # パイプが壊れた(release は必ず行う必要がある)
def write(self, frame_bgr):
if self._closed or self._broken:
return
try:
self._proc.stdin.write(np.ascontiguousarray(frame_bgr).tobytes())
except (BrokenPipeError, OSError, ValueError) as e:
print(f" ffmpeg へのフレーム書き込みに失敗しました: {e}")
self._failed = True
# _closed は立てない。release() で stdin を閉じて子プロセスを回収しないと
# ffmpeg が stdin 待ちのまま残り、プロセス終了時にハングする。
self._broken = True
def isOpened(self):
return not self._failed and not self._closed
def release(self):
if not self._closed:
self._closed = True
try:
self._proc.stdin.close()
except (OSError, ValueError):
pass
rc = self._proc.wait()
if rc != 0:
self._failed = True
self._log(f"ffmpeg が異常終了しました (rc={rc})")
self._log("") # ログを消す(異常時は中身を出力)
try:
if self._proc.stderr:
self._proc.stderr.close()
except Exception:
pass
def _log(self, message):
try:
with open(self._log_path, "r", encoding="utf-8", errors="replace") as f:
msg = f.read().strip()
except OSError:
msg = ""
if msg:
print(f" {message}: {msg[:300]}")
try:
os.remove(self._log_path)
except OSError:
pass
def _open_ffmpeg_writer(path, fps, size, crf=20):
"""ffmpeg で H.264(baseline / yuv420p / faststart)を書き出す。失敗したら None"""
ffmpeg = _ffmpeg_exe()
if not ffmpeg:
return None
w, h = int(size[0]), int(size[1])
log_path = path + ".ffmpeg.log"
cmd = [
ffmpeg, "-y", "-loglevel", "error",
"-f", "rawvideo", "-pix_fmt", "bgr24",
"-s", f"{w}x{h}", "-framerate", f"{fps:.6f}", "-i", "pipe:0",
"-an",
"-c:v", "libx264", "-preset", "veryfast", "-crf", str(crf),
"-profile:v", "baseline", "-level", "3.1",
"-pix_fmt", "yuv420p", "-movflags", "+faststart",
path,
]
try:
err_fp = open(log_path, "wb")
except OSError:
return None
try:
proc = subprocess.Popen(
cmd, stdin=subprocess.PIPE, stdout=subprocess.DEVNULL, stderr=err_fp
)
except Exception as e:
try:
err_fp.close()
os.remove(log_path)
except OSError:
pass
print(f" ffmpeg を起動できませんでした(OpenCV にフォールバックします): {e}")
return None
err_fp.close() # 子プロセスが継承した FD はそのまま
writer = _FfmpegVideoWriter(proc, log_path)
if writer.isOpened():
return writer
return None
def _pick_video_backend():
"""ffmpeg が使えるか 1 回だけ判定する(OpenCV より高速・ログが静か・画質を明示指定できる)"""
global _VIDEO_BACKEND
if _VIDEO_BACKEND is not None:
return _VIDEO_BACKEND
probe_path = os.path.join(tempfile.gettempdir(), "sam2_video_encoder_probe.mp4")
probe = _open_ffmpeg_writer(probe_path, 10.0, (32, 32), crf=30)
ok = False
if probe is not None:
for _ in range(3):
probe.write(np.zeros((32, 32, 3), dtype=np.uint8))
probe.release()
ok = os.path.exists(probe_path) and os.path.getsize(probe_path) > 0
try:
os.remove(probe_path)
except OSError:
pass
_VIDEO_BACKEND = "ffmpeg" if ok else "opencv"
if ok:
print(" エンコーダ: ffmpeg (libx264 baseline / yuv420p)")
else:
print(" エンコーダ: OpenCV VideoWriter(avc1)")
return _VIDEO_BACKEND
def _create_video_writer(path, fps, size, crf=20):
"""動画書き出し用の writer を作る。backend が判れば (writer, backend名) を返す"""
if _pick_video_backend() == "ffmpeg":
writer = _open_ffmpeg_writer(path, fps, size, crf=crf)
if writer is not None:
return writer, "ffmpeg"
global _VIDEO_BACKEND
_VIDEO_BACKEND = "opencv" # 実行時に失敗したので以降は OpenCV に切替える
global _WORKING_FOURCC
order = list(_BROWSER_CODECS)
if _WORKING_FOURCC in order: # 前回成功した FourCC を最優先(探索コストを省略)
order.remove(_WORKING_FOURCC)
order.insert(0, _WORKING_FOURCC)
for cc in order:
with _silence_stderr(): # libopenh264 の load 失敗ログ suppress
writer = cv2.VideoWriter(path, cv2.VideoWriter_fourcc(*cc), fps, size)
if writer.isOpened():
_WORKING_FOURCC = cc
return writer, f"OpenCV({cc})"
writer.release()
return None, None
def _ffmpeg_exe():
"""faststart 付きに mux し直すための ffmpeg(無ければ None)"""
exe = shutil.which("ffmpeg")
if exe:
return exe
try:
import imageio_ffmpeg
return imageio_ffmpeg.get_ffmpeg_exe()
except Exception:
return None
def _remux_faststart(path):
"""moov を先頭に置いて、ブラウザがDL完了を待たずに再生できるようにする(ベストエフォート)"""
ffmpeg = _ffmpeg_exe()
if not ffmpeg or not os.path.exists(path):
return False
tmp_path = path + "_faststart.mp4"
try:
result = subprocess.run(
[ffmpeg, "-y", "-loglevel", "error", "-i", path,
"-c", "copy", "-movflags", "+faststart", tmp_path],
stdout=subprocess.PIPE, stderr=subprocess.PIPE, timeout=300,
)
if result.returncode == 0 and os.path.exists(tmp_path) and os.path.getsize(tmp_path) > 0:
shutil.move(tmp_path, path)
return True
except Exception as e:
print(f" faststart 化はスキップします: {e}")
if os.path.exists(tmp_path):
try:
os.remove(tmp_path)
except OSError:
pass
return False
@torch.inference_mode()
def on_first_frame_click(points, evt: gr.SelectData, cur_label=1):
"""動画の第1フレームをクリックして対象を指定(IOPaint と同じ方式)"""
first_pil = _video_state["first_frame_pil"]
if first_pil is None:
return points or [], None, "第1フレームが読み込まれていません"
coord, err_msg = extract_coords(evt, first_pil)
if coord is None:
return points or [], first_pil, err_msg
x, y = coord
new_points = (points or []) + [[x, y, 1 if int(cur_label) else 0]]
# 1フレーム目でのSAM2プレビュー
try:
image_np = ensure_image_set(first_pil)
point_coords = np.array([p[:2] for p in new_points], dtype=np.float32)
point_labels = np.array([_point_label(p) for p in new_points], dtype=np.int32)
masks, scores, _ = image_predictor.predict(
point_coords=point_coords,
point_labels=point_labels,
multimask_output=False
)
if isinstance(masks, torch.Tensor):
masks = masks.detach().cpu().numpy()
if isinstance(scores, torch.Tensor):
scores = scores.detach().cpu().numpy()
best_mask = masks[0]
if best_mask.ndim == 3 and best_mask.shape[0] == 1:
best_mask = best_mask.squeeze(0)
bool_mask = (best_mask > 0.0)
overlay = image_np.copy()
orange_color = np.array([255, 140, 0], dtype=np.float32)
alpha = 0.5
if bool_mask.any():
target_pixels = overlay[bool_mask].astype(np.float32)
blended = target_pixels * (1.0 - alpha) + orange_color * alpha
overlay[bool_mask] = np.clip(blended, 0, 255).astype(np.uint8)
result_img = Image.fromarray(overlay)
result_img = draw_points(result_img, new_points)
n_pos = int(sum(_point_label(p) for p in new_points))
n_neg = len(new_points) - n_pos
return new_points, result_img, (
f"追加 {n_pos} / 除外 {n_neg} 指定中。"
"「動画全体を自動トラッキング」を押してください。"
)
except Exception as e:
img_marked = draw_points(first_pil, new_points)
return new_points, img_marked, f"プレビュー生成に失敗しました: {e}"
def run_video_tracking(points, progress=gr.Progress(track_tqdm=True)):
"""第1フレームの指定点をもとに、SAM2で動画全フレームを自動追跡&エクスポート
※ Gradio の進捗送信は「レスポンス開始後」になるため、ここで例外を投げると
Starlette が "Caught handled exception, but response already started" に化けて
本当の原因が消える。例外は全て _log_exception で記録し、ステータスとして返す。
"""
temp_dir = _video_state["temp_dir"]
total_frames = _video_state["total_frames"]
if not temp_dir or total_frames == 0:
return None, None, None, None, "先に動画をアップロードしてください"
if not points or len(points) == 0:
return None, None, None, None, "第1フレームに対象をクリックして指定してください"
# 途中で return / 例外が出ても ffmpeg 子プロセスと作業用ディレクトリを必ず片付ける
active_writers = []
temp_masks_dir = None
try:
progress(0.1, desc="SAM2 動画トラッキングモデルの初期化...")
v_predictor = get_video_predictor()
inference_state = v_predictor.init_state(video_path=temp_dir)
v_predictor.reset_state(inference_state)
# 第1フレーム(frame_idx=0)にプロンプト(ポイント+追加/除外ラベル)を登録
pts_arr = np.array([p[:2] for p in points], dtype=np.float32)
lbls_arr = np.array([_point_label(p) for p in points], dtype=np.int32)
v_predictor.add_new_points_or_box(
inference_state=inference_state,
frame_idx=0,
obj_id=1,
points=pts_arr,
labels=lbls_arr,
)
# 出力ファイル設定
timestamp = time.strftime("%Y%m%d_%H%M%S")
out_overlay_path = os.path.join(OUTPUTS_DIR, f"tracked_overlay_{timestamp}.mp4")
out_mask_path = os.path.join(OUTPUTS_DIR, f"tracked_mask_{timestamp}.mp4")
out_zip_path = os.path.join(OUTPUTS_DIR, f"tracked_masks_png_{timestamp}.zip")
fps = _video_state["fps"]
if not fps or fps <= 0:
fps = 30.0
# H.264 は偶数サイズでないと書けない
width = _even_dim(_video_state["width"])
height = _even_dim(_video_state["height"])
writer_overlay, backend = _create_video_writer(out_overlay_path, fps, (width, height), crf=20)
if writer_overlay is None:
return None, None, None, None, (
"動画書き出しに失敗しました(ffmpeg / OpenCV のどちらも使えません)"
)
writer_mask, _ = _create_video_writer(out_mask_path, fps, (width, height), crf=26)
active_writers.extend([writer_overlay, writer_mask])
if writer_mask is None:
writer_overlay.release()
return None, None, None, None, "マスク動画書き出しに失敗しました"
# 連番PNGマスクをZIPに含めるための準備
temp_masks_dir = tempfile.mkdtemp(prefix="sam2_masks_zip_")
progress(0.2, desc="全フレームを自動追跡中...")
written = 0
pool = ThreadPoolExecutor(max_workers=8) # PNG 書き出しはスレッドで並列化(cv2 は GIL を解放する)
# JPEG デコード(1 フレーム 20ms 程度)は GIL を解放するので、別スレッドで先読みして
# GPU 合成・H.264 エンコードと重叠させる。メモリは先読み分数だけ。
frame_files = [
p for p in (os.path.join(temp_dir, f"{i:05d}.jpg") for i in range(total_frames))
if os.path.exists(p)
]
frame_bytes = max(1, width * height * 3)
lookahead = int(min(8, max(2, 96 * 1024 * 1024 // frame_bytes)))
prefetch_pool = ThreadPoolExecutor(max_workers=4)
pending = {}
submitted = 0
def _fill_prefetch():
"""未 submit のフレームのうち、先読み枠が空くまで読み込みを開始する"""
nonlocal submitted
while len(pending) < lookahead and submitted < len(frame_files):
idx = submitted
pending[idx] = prefetch_pool.submit(cv2.imread, frame_files[idx])
submitted += 1
_fill_prefetch()
# Gradio の進捗はレスポンス開始後に送られるため、ここで raise すると
# Starlette が "response already started" に化けて本当の原因が消える。
# そのため 1 フレームずつ try/except でくるみ、どのフレームで何が起きたかを
# error_log.txt に残してからステータスとして返す。
loop_error = None
loop_error_frame = None
try:
# propagate_in_video で全フレーム順次追跡
for frame_idx, obj_ids, video_res_masks in v_predictor.propagate_in_video(inference_state):
try:
if frame_idx < len(frame_files):
fut = pending.pop(frame_idx, None)
frame_bgr = fut.result() if fut is not None else cv2.imread(frame_files[frame_idx])
else:
orig_frame_file = os.path.join(temp_dir, f"{frame_idx:05d}.jpg")
if not os.path.exists(orig_frame_file):
continue
frame_bgr = cv2.imread(orig_frame_file)
_fill_prefetch()
if frame_bgr is None:
continue
# VideoWriter のサイズに合わせる(偶数サイズに丸める)
if frame_bgr.shape[1] != width or frame_bgr.shape[0] != height:
frame_bgr = cv2.resize(frame_bgr, (width, height), interpolation=cv2.INTER_AREA)
# マスクは SAM2 から GPU 上のまま受け取る
mask_t = video_res_masks[0]
if mask_t.dim() > 2:
mask_t = mask_t.reshape(-1, *mask_t.shape[-2:])[0]
mask_bool_gpu = mask_t > 0.0
# 白黒マスク(白黒マスク動画と連番PNGの両方で使うため 1 回だけ CPU へ戻す)
bw_mask = (mask_bool_gpu.to(torch.uint8) * 255).cpu().numpy().squeeze()
if bw_mask.shape != (height, width):
bw_mask = cv2.resize(
bw_mask, (width, height), interpolation=cv2.INTER_NEAREST
)
# 1. オーバーレイフレームの合成(OOM が起きても CPU に自動で切り替わる)
overlay_bgr = _blend_overlay(frame_bgr, mask_bool_gpu, bw_mask)
writer_overlay.write(overlay_bgr)
# 2. 白黒マスクフレーム
writer_mask.write(cv2.cvtColor(bw_mask, cv2.COLOR_GRAY2BGR))
# 3. 連番PNGの保存(バックグラウンドで並列実行)
mask_png_file = os.path.join(temp_masks_dir, f"mask_{frame_idx:05d}.png")
pool.submit(cv2.imwrite, mask_png_file, bw_mask)
written += 1
current_prog = 0.2 + 0.7 * ((frame_idx + 1) / total_frames)
progress(current_prog, desc=f"フレーム追跡中: {frame_idx + 1}/{total_frames}")
except Exception as e:
loop_error = e
loop_error_frame = frame_idx
_log_exception(f"フレーム {frame_idx} の処理", e)
break
finally:
prefetch_pool.shutdown(wait=False, cancel_futures=True)
pool.shutdown(wait=True) # 裏で走っている PNG 書き出しを必ず待つ
writer_overlay.release()
writer_mask.release()
if loop_error is not None:
written_txt = f"{written} フレーム処理後に"
if isinstance(loop_error, MemoryError) or "out of memory" in str(loop_error).lower():
msg = f"GPU メモリが不足しました({written_txt}停止)。「処理する最大フレーム数」を小さくしてください。"
else:
msg = f"フレーム {loop_error_frame} でエラーが発生しました({written_txt}停止): {type(loop_error).__name__}"
return None, None, None, None, msg
if getattr(writer_overlay, "_failed", False) or getattr(writer_mask, "_failed", False):
return None, None, None, None, "動画の書き出し中にエラーが発生しました(詳しい情報は error_log.txt を確認してください)"
if written == 0 or not os.path.exists(out_overlay_path) or os.path.getsize(out_overlay_path) == 0:
return None, None, None, None, "書き出した動画ファイルが空です(フレームの展開に失敗した可能性があります)"
# ブラウザが再生しやすいように moov を先頭へ(OpenCV 経路のときだけ。ffmpeg は書き込み時に付与済み)
if backend != "ffmpeg":
_remux_faststart(out_overlay_path)
_remux_faststart(out_mask_path)
# ZIPアーカイブを作成
progress(0.95, desc="ZIPアーカイブを作成中...")
with zipfile.ZipFile(out_zip_path, 'w', zipfile.ZIP_DEFLATED) as zipf:
for root, _, files in os.walk(temp_masks_dir):
for file in files:
file_path = os.path.join(root, file)
zipf.write(file_path, arcname=file)
shutil.rmtree(temp_masks_dir, ignore_errors=True)
progress(1.0, desc="完了!")
overlay_mb = os.path.getsize(out_overlay_path) / (1024 * 1024)
mask_mb = os.path.getsize(out_mask_path) / (1024 * 1024)
status_msg = (
f"トラッキング完了! 全 {written} フレーム保存({width}x{height} / {fps:.1f}fps / "
f"エンコーダ: {backend})| オーバーレイ {overlay_mb:.1f}MB・マスク {mask_mb:.1f}MB"
)
return out_overlay_path, out_mask_path, out_mask_path, out_zip_path, status_msg
except Exception as e:
_log_exception("トラッキング全体", e)
if isinstance(e, MemoryError) or "out of memory" in str(e).lower():
try:
torch.cuda.empty_cache()
except Exception:
pass
return None, None, None, None, (
f"GPU メモリが不足しました: {e} / 「処理する最大フレーム数」を小さくしてください。"
)
return None, None, None, None, (
f"トラッキング中にエラーが発生しました: {type(e).__name__}: {e}(詳細は error_log.txt)"
)
finally:
# 二重 release は安全(_FfmpegVideoWriter は _closed、cv2 は内部フラグで弾く)
for w in active_writers:
if w is None:
continue
try:
w.release()
except Exception:
pass
# 作業用マスクディレクトリ(エラー時は ZIP に詰めるので削除してよい)
if temp_masks_dir and os.path.isdir(temp_masks_dir):
shutil.rmtree(temp_masks_dir, ignore_errors=True)
# ----------------------------------------------------
# Gradio UI 構築
# ----------------------------------------------------
with gr.Blocks(title="SAM2 セグメンテーション & 動画トラッキング") as demo:
gr.Markdown("# 🚀 SAM2 セグメンテーション & 動画トラッキング")
gr.Markdown("画像・動画の対象(モザイク領域など)をクリックで指定し、**オレンジ色オーバーレイ表示 & 白黒マスク・動画のエクスポート**を行います。")
gr.Markdown(
"**指定方法(IOPaint と同じ挙動)**:「対象に追加」で対象を選び、"
"取り除きたい部分は「対象から除外」に切り替えてから点を追加します。"
"追加=オレンジの点(label 1)/除外=水色の点(label 0)。"
)
with gr.Tabs():
# ==========================================
# タブ 1: 静止画セグメンテーション
# ==========================================
with gr.Tab("🖼️ 静止画セグメンテーション"):
with gr.Row():
img_input = gr.Image(type="pil", label="入力画像(クリックすると即座にセグメンテーション)")
img_overlay = gr.Image(type="pil", label="セグメンテーション結果(オレンジ色オーバーレイ)")
img_mask_bw = gr.Image(type="pil", label="白黒マスク(0:背景, 255:対象)")
img_points_state = gr.State([])
img_status = gr.Textbox(label="ステータス", value="画像をアップロードして対象をクリックしてください", interactive=False)
img_point_mode = gr.Radio(
[("対象に追加(+)", 1), ("対象から除外(−)", 0)],
value=1,
label="クリックモード",
info="「追加」はオレンジの点、「除外」は水色の点として扱われます(IOPaint と同じ挙動)"
)
with gr.Row():
img_clear_btn = gr.Button("選択点をクリア / リセット")
file_download_mask = gr.File(label="白黒マスク(PNG) ダウンロード", interactive=False)
file_download_json = gr.File(label="クリック座標(JSON) ダウンロード", interactive=False)
img_input.change(
on_image_reset,
inputs=[img_input],
outputs=[img_points_state, img_overlay, img_mask_bw, file_download_mask, file_download_json, img_status]
)
img_input.select(
on_image_select,
inputs=[img_input, img_points_state, img_point_mode],
outputs=[img_points_state, img_overlay, img_mask_bw, file_download_mask, file_download_json, img_status]
)
img_clear_btn.click(
on_image_reset,
inputs=[img_input],
outputs=[img_points_state, img_overlay, img_mask_bw, file_download_mask, file_download_json, img_status]
)
# クリックが反映されない場合の代替手段(座標直接指定)
with gr.Accordion("手動座標で指定(クリックが反応しないとき用)", open=False):
gr.Markdown("元画像の座標(X: 横, Y: 縦、0 起点)で指定します。画像はステータスにサイズが表示されます。")
with gr.Row():
manual_x = gr.Number(label="X(0 ≦ X < 画像幅)", value=0, precision=0)
manual_y = gr.Number(label="Y(0 ≦ Y < 画像高さ)", value=0, precision=0)
manual_btn = gr.Button("この座標でセグメンテーション")
manual_btn.click(
on_image_manual_point,
inputs=[img_input, img_points_state, manual_x, manual_y, img_point_mode],
outputs=[img_points_state, img_overlay, img_mask_bw, file_download_mask, file_download_json, img_status]
)
# ==========================================
# タブ 2: 動画トラッキング
# ==========================================
with gr.Tab("🎬 動画自動トラッキング"):
gr.Markdown("### ① 動画アップロード ➔ ② 第1フレームをクリック ➔ ③ 自動トラッキング開始")
with gr.Row():
with gr.Column(scale=1):
video_input = gr.Video(label="動画ファイルをアップロード")
max_frames_slider = gr.Slider(minimum=30, maximum=1000, value=300, step=30, label="処理する最大フレーム数(長時間のメモリ節約用)")
vid_clear_btn = gr.Button("第1フレームの指定点をリセット")
track_btn = gr.Button("🚀 動画全体を自動トラッキング開始", variant="primary")
with gr.Column(scale=2):
first_frame_view = gr.Image(type="pil", label="第1フレーム(対象をクリックしてオレンジ色で指定)")
vid_points_state = gr.State([])
vid_status = gr.Textbox(label="トラッキング進捗 / 状態", value="動画をアップロードしてください", interactive=False)
vid_point_mode = gr.Radio(
[("対象に追加(+)", 1), ("対象から除外(−)", 0)],
value=1,
label="第1フレームのクリックモード"
)
with gr.Row():
video_overlay_out = gr.Video(label="オレンジ色オーバーレイ動画プレビュー")
video_mask_out = gr.Video(label="白黒マスク動画プレビュー")
with gr.Row():
file_tracked_mask_mp4 = gr.File(label="白黒マスク動画 (MP4) ダウンロード")
file_tracked_zip = gr.File(label="全フレーム白黒マスク連番 (ZIP) ダウンロード")
# 動画アップロード時にフレーム抽出
video_input.change(
on_video_upload,
inputs=[video_input, max_frames_slider],
outputs=[first_frame_view, vid_points_state, video_overlay_out, video_mask_out, file_tracked_mask_mp4, file_tracked_zip, vid_status]
)
# 第1フレームクリック時に点追加&オレンジプレビュー
first_frame_view.select(
on_first_frame_click,
inputs=[vid_points_state, vid_point_mode],
outputs=[vid_points_state, first_frame_view, vid_status]
)
# リセットボタン
def reset_vid_points():
first_pil = _video_state.get("first_frame_pil", None)
return [], first_pil, "クリック点をクリアしました。再度対象をクリックしてください。"
vid_clear_btn.click(
reset_vid_points,
inputs=None,
outputs=[vid_points_state, first_frame_view, vid_status]
)
# トラッキング実行ボタン
track_btn.click(
run_video_tracking,
inputs=[vid_points_state],
outputs=[video_overlay_out, video_mask_out, file_tracked_mask_mp4, file_tracked_zip, vid_status]
)
# ※ Gradio 4 では gr.Progress の進捗配信は queue() 必須(helpers.py:494)。
# queue() が無いとエラー伝播経路も崩れ、
# 「RuntimeError: Caught handled exception, but response already started」になる。
demo.queue(max_size=32, status_update_rate="auto")
# ※ launch() は __main__ 時だけ。ガード無しだと import しただけで
# サーバーが起動してプロセスが終わらなくなる(テスト・外部利用で詰まる)。
if __name__ == "__main__":
demo.launch()